 进阶
AI提效技术指标权重机制AI重构公开课精华
AI 重构技术指标的关键,不是更复杂,而是重写了“权重怎么来”
从第四场公开课出发,解释 AI 为什么能重构技术指标,以及“权重生成机制”这个视角为何是理解 AI 因子工厂的关键入口。
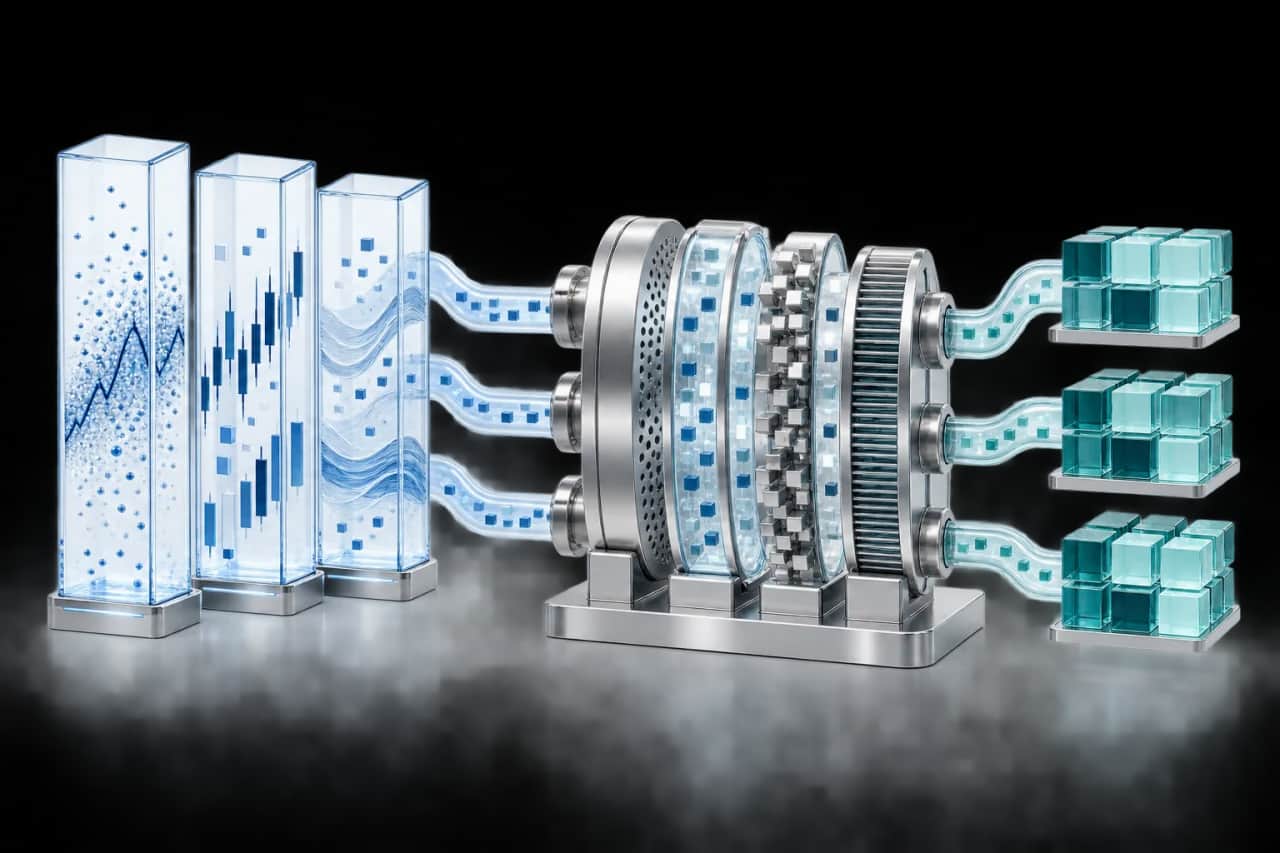
很多学习者会把技术指标和 AI 模型看成两套几乎对立的东西。前者像是经典时代遗留下来的固定工具箱,后者像是现代智能模型的全新世界。但第四场公开课做了一件非常重要的事:它把两者都拉回到“权重怎么生成”这个底层问题上。只要视角切到这里,你就会发现 SMA、EMA、LSTM、Attention 其实不是四种完全不相干的工具,而是四种不同层级的权重生成机制。
这也是 AI 能重构技术指标而不是单纯替代技术指标的原因。它不是把旧指标全盘丢掉,而是把原来固定、手工、静态的权重生成方式,逐步升级成更动态、更有上下文感知能力的权重机制。
一旦理解了权重机制,技术指标学习会彻底变样
理解技术指标的最好方式,不再是死记每个公式,而是先问:它在给谁分配权重?这些权重是固定的、衰减的、状态驱动的,还是内容驱动的?当你这样去看技术指标时,传统指标和 AI 模型之间的墙就会开始消失,取而代之的是一条清晰演化链。
也正因此,这门公开课对很多技术指标使用者会非常有启发。因为它第一次让人看懂:AI 不是一套陌生的替代物,而是技术指标背后那套“权重逻辑”的更高阶版本。
实践示例与验证边界
教学示例:对两个观测值10和14,用固定权重0.5、0.5得到12;改成0.25、0.75得到13。变化来自权重规则,而不是输入数据本身。这个小例子用于区分“信号输入”和“权重生成机制”。
- 先明确输入和时间顺序,再写出权重、归一化与输出的计算过程。
- 比较固定权重、依赖状态的权重和依赖内容的权重,记录新增的自由度。
- 为可学习规则设置时间隔离与样本外检验,检查是否增加了搜索偏差。
权重生成是帮助理解机制的视角,不表示传统指标与完整神经网络在结构、训练过程或效果上等价。示例没有证明交易预测能力。
资料与延伸阅读
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- AI 重构技术指标的关键,是改写了权重生成方式
- SMA、EMA、LSTM、Attention 可以看成一条权重进化链
- 理解权重机制后,技术指标和 AI 就不再是两套割裂系统
关联课程
如果你想把这篇文章里的方法系统化学习,可以从这些课程继续深入。
进阶 提效