论文解读模型评价决策质量排序相关性研究方法
预测误差降了,交易决策价值就会提高吗?
一篇储能论文报告:预测误差下降约53%,价值捕获仅增加0.5个百分点。本文核对原表、解释决策机制,并讨论排序、成本与资源约束的适用边界。
本文解读论文
When Forecast Accuracy Fails: Rank Correlation and Decision Quality in Multi-Market Battery Storage Optimization
arXiv preprint | 2026-04-13 | Alessandro Falezza
模型的预测误差又降了一半,交易表现却只动了一点。遇到这种结果,研究该继续调模型,还是回头检查决策过程?
Alessandro Falezza在2026年4月的一篇预印本中,研究了德国和瑞士多市场电池储能调度。论文最值得量化研究者关注的,是预测质量经过交易规则和资源约束之后,究竟剩下多少经济价值。
先把边界说清:这是一项电力储能研究,不是股票因子实证。文中的排序阈值不能拿来当选股标准,接近“完美预知”的收益比例,也不等于真实投资收益率。
图图1
预测指标与决策价值
误差下降53%,价值捕获只增加0.5个百分点
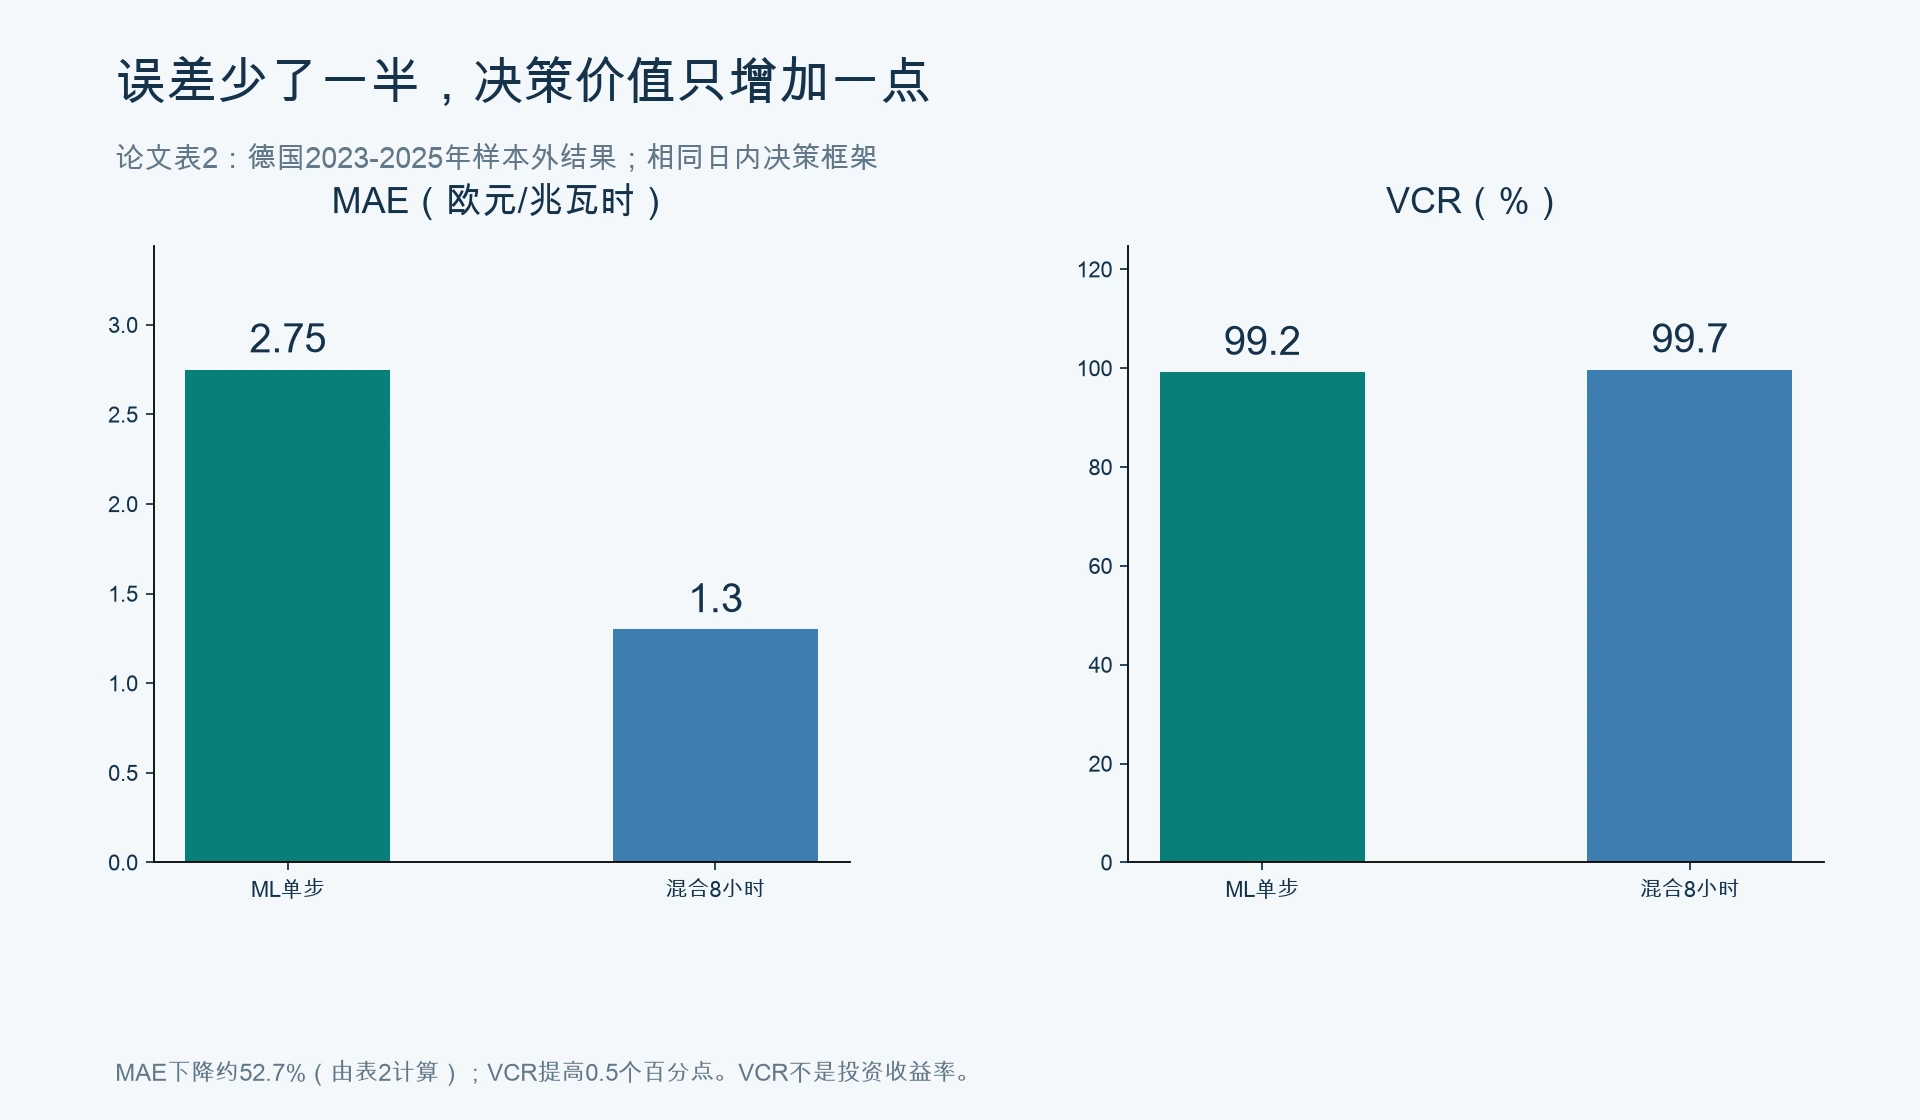
论文表2列出了德国2023至2025年样本外结果。机器学习单步预测的MAE为2.75欧元/兆瓦时,Kendall排序相关系数为0.918,价值捕获比例VCR为99.2%。混合8小时预测对应的数字是1.30、0.948和99.7%。
MAE衡量预测价格离实际价格有多远。按表中数字计算,从2.75降到1.30,误差下降约52.7%,论文将其取整为53%;VCR却只提高0.5个百分点。
VCR的分母,是在相同决策框架和可行约束下,使用事后真实价格得到的基准收益。99.7%表示接近该特定基准,既不是99.7%的收益率,也不能与另一套容量约束下的99.7%直接比较。
这里还有一个容易被标题带偏的细节:表2的五个模型,按MAE与VCR排出的名次完全一致,论文也明确给出RI=0。因此,这组结果没有证明“误差更小的模型反而赚得更少”。它展示的是:误差改善幅度与决策价值的改善幅度,可能相差很大。
图图2
论文表2:MAE与价值捕获比例比较
预测值要经过决策规则,才会变成收益
电池在相对便宜的时段充电,在相对昂贵的时段放电。预测把哪些时段看成低点、哪些看成高点,会影响交易时机。如果两个模型最终触发同一套充放电安排,预测数字再精细,也未必改变实际结果。
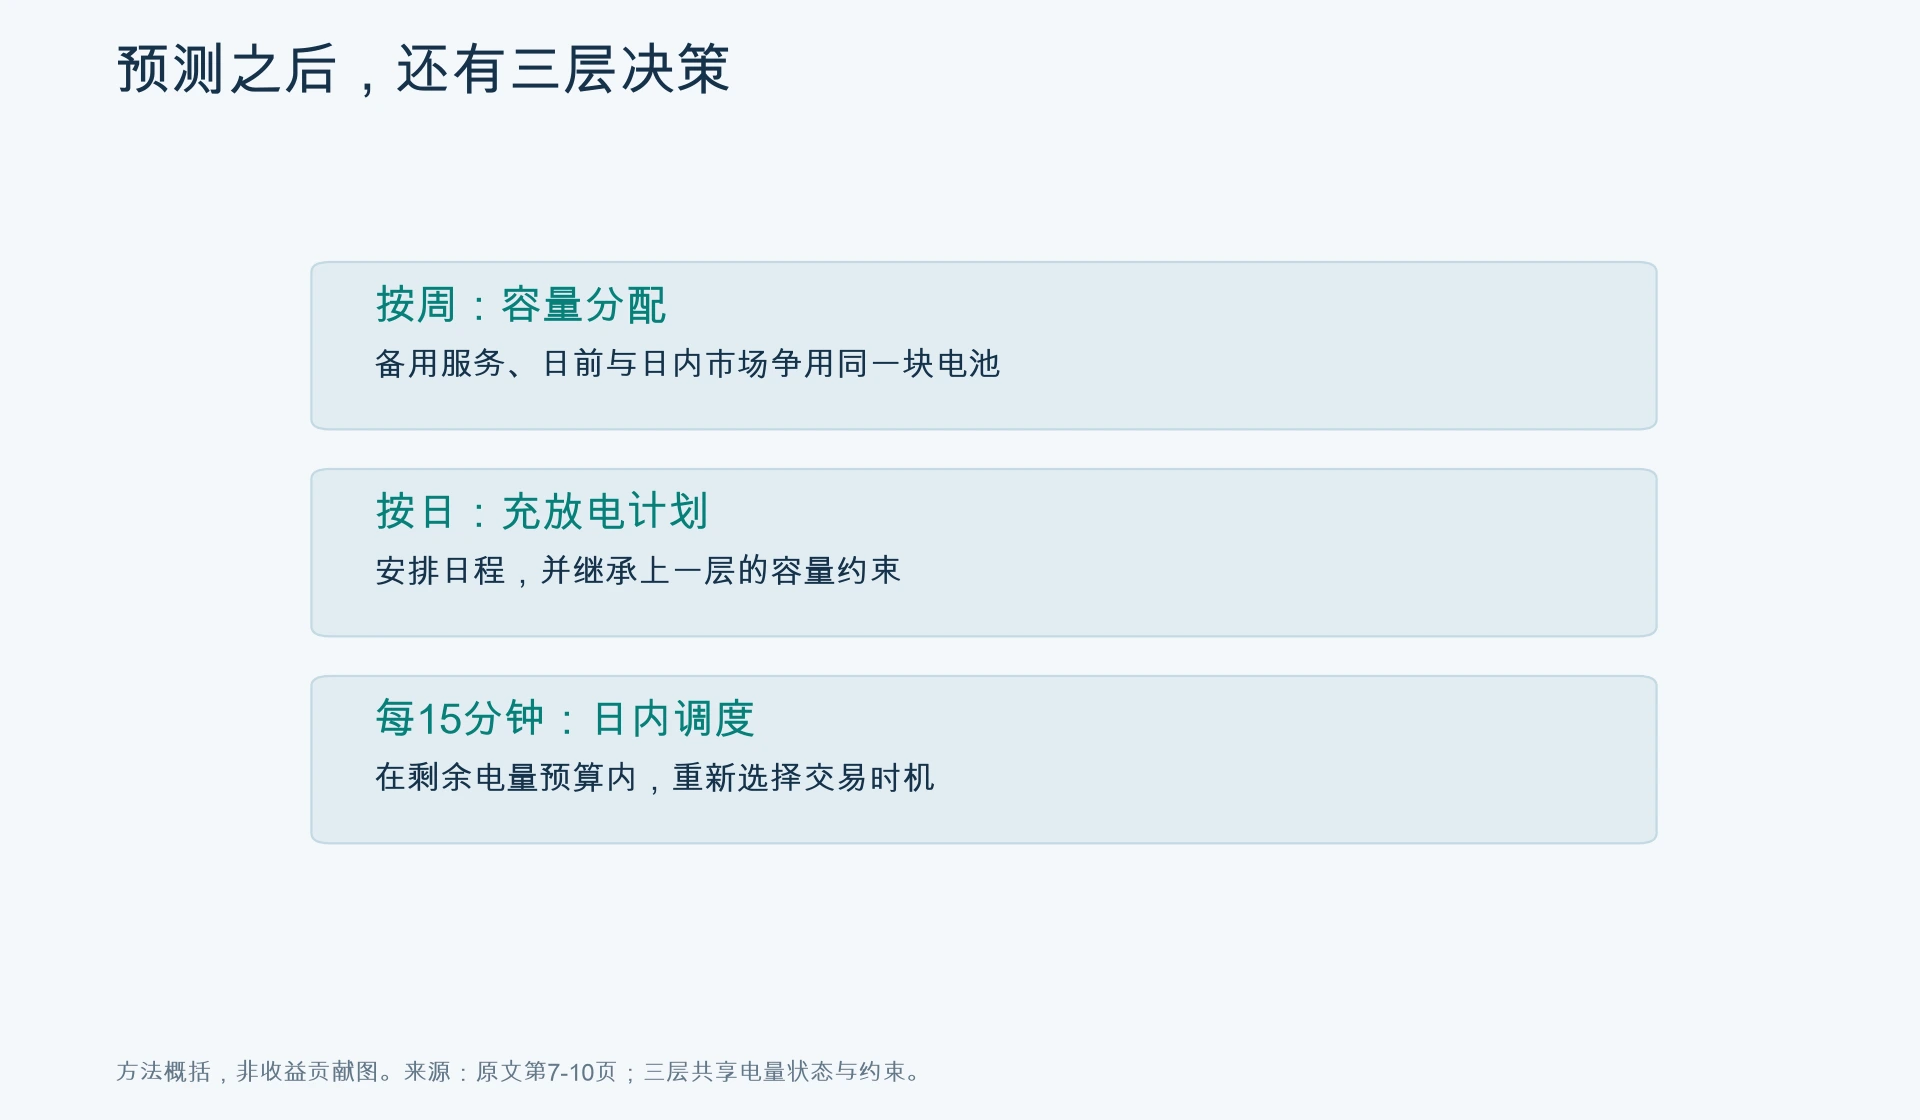
论文把系统分成三层。第一层按周分配各市场的容量;第二层安排日前充放电计划;第三层每15分钟重新优化日内调度。三层共用电池的电量状态,不能各自把同一份容量用满。
研究覆盖2020至2025年的数据,核心预测模型比较使用德国2023至2025年的样本外区间。模拟电池为10MW、10MWh,往返效率90.25%,并考虑退化成本。读结果时,这些条件与模型名字同样重要。
图图3
论文三层决策系统及共享资源约束
排序有用,不代表价格幅度可以忽略
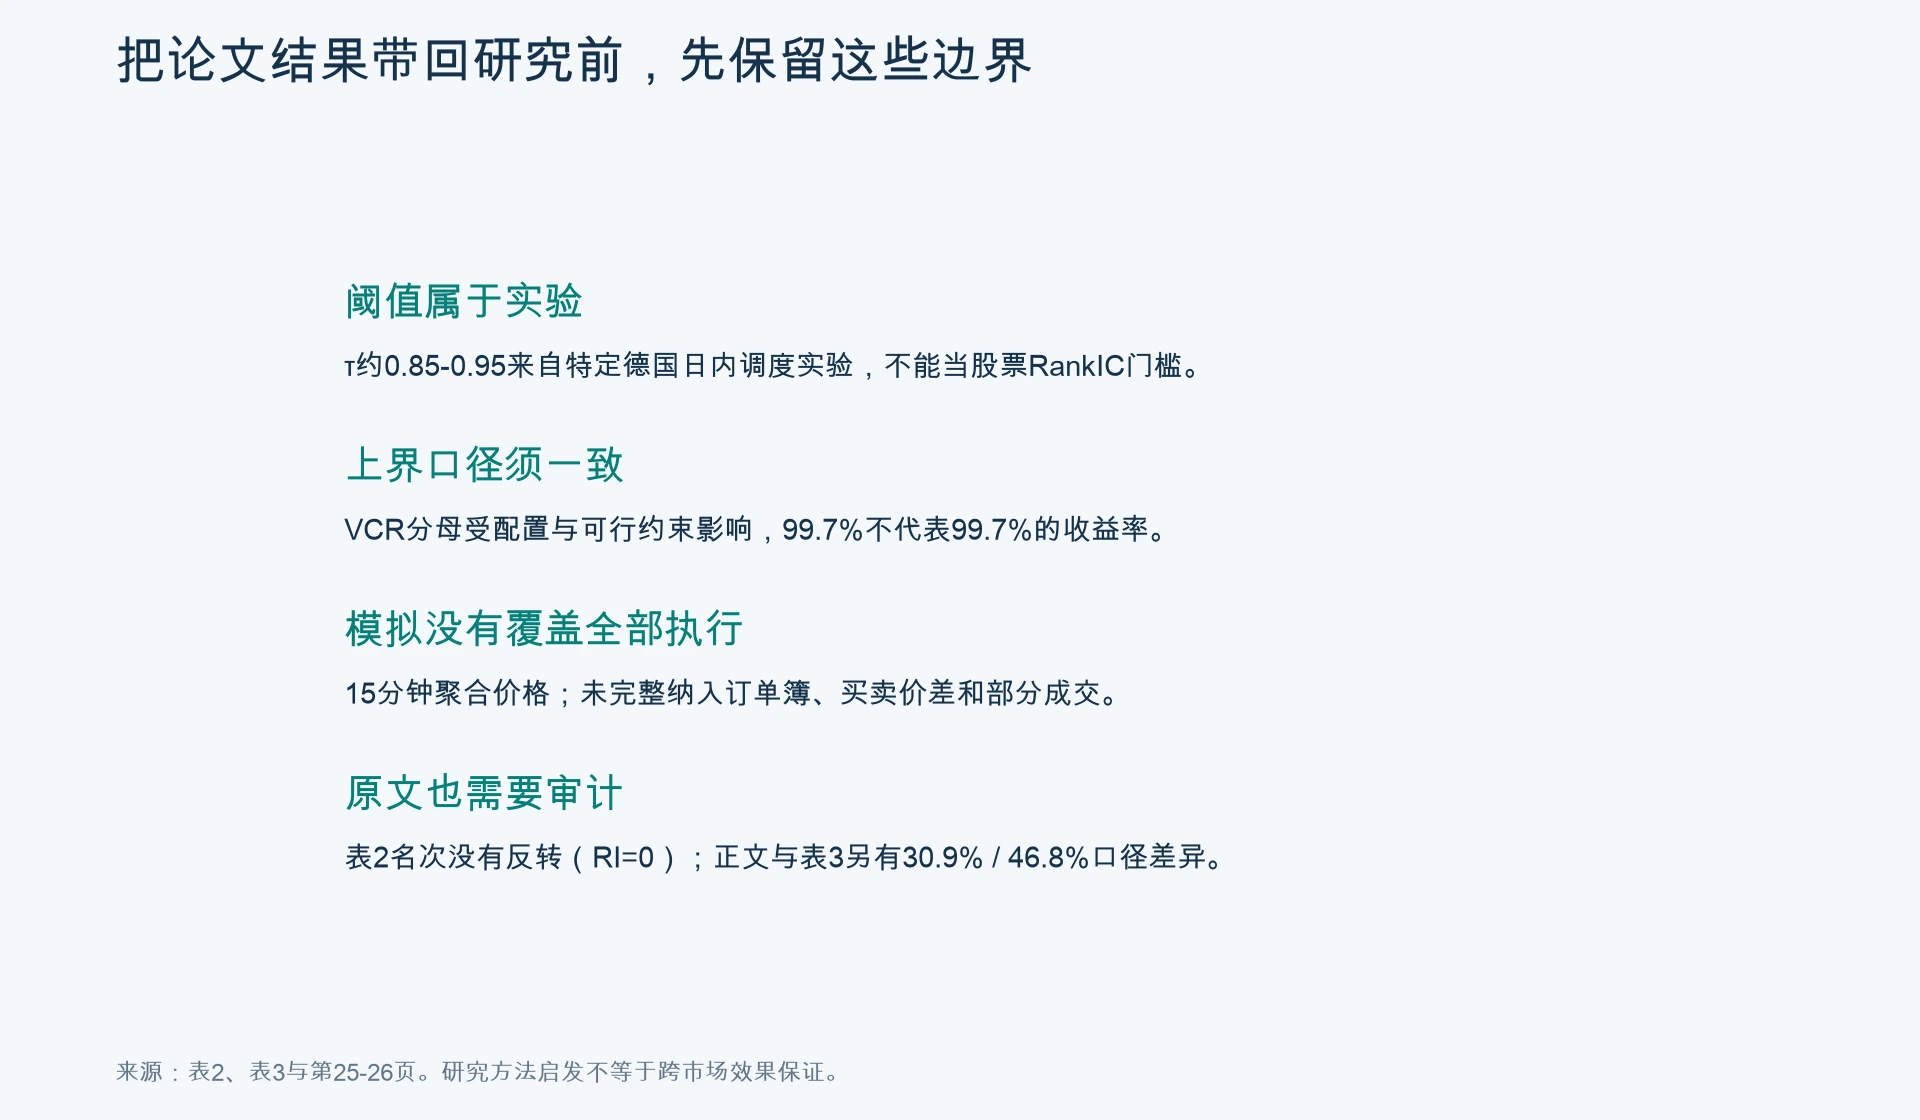
作者用24,000次控制排序相关性的合成预测模拟,报告Kendall τ约0.85至0.95后,VCR进入接近97%至100%的平台区。这个数值区间是论文在特定市场、调度方法与实验设置下得到的经验结果,不能直接迁移为股票RankIC或任何策略的通用阈值。
更需要审慎的是,正文把机制表述为“任意单调变换都给出相同充放电决策”。只要系统存在效率损失、交易成本或其他约束,仅保留高低次序通常不足以保证最优决策不变。
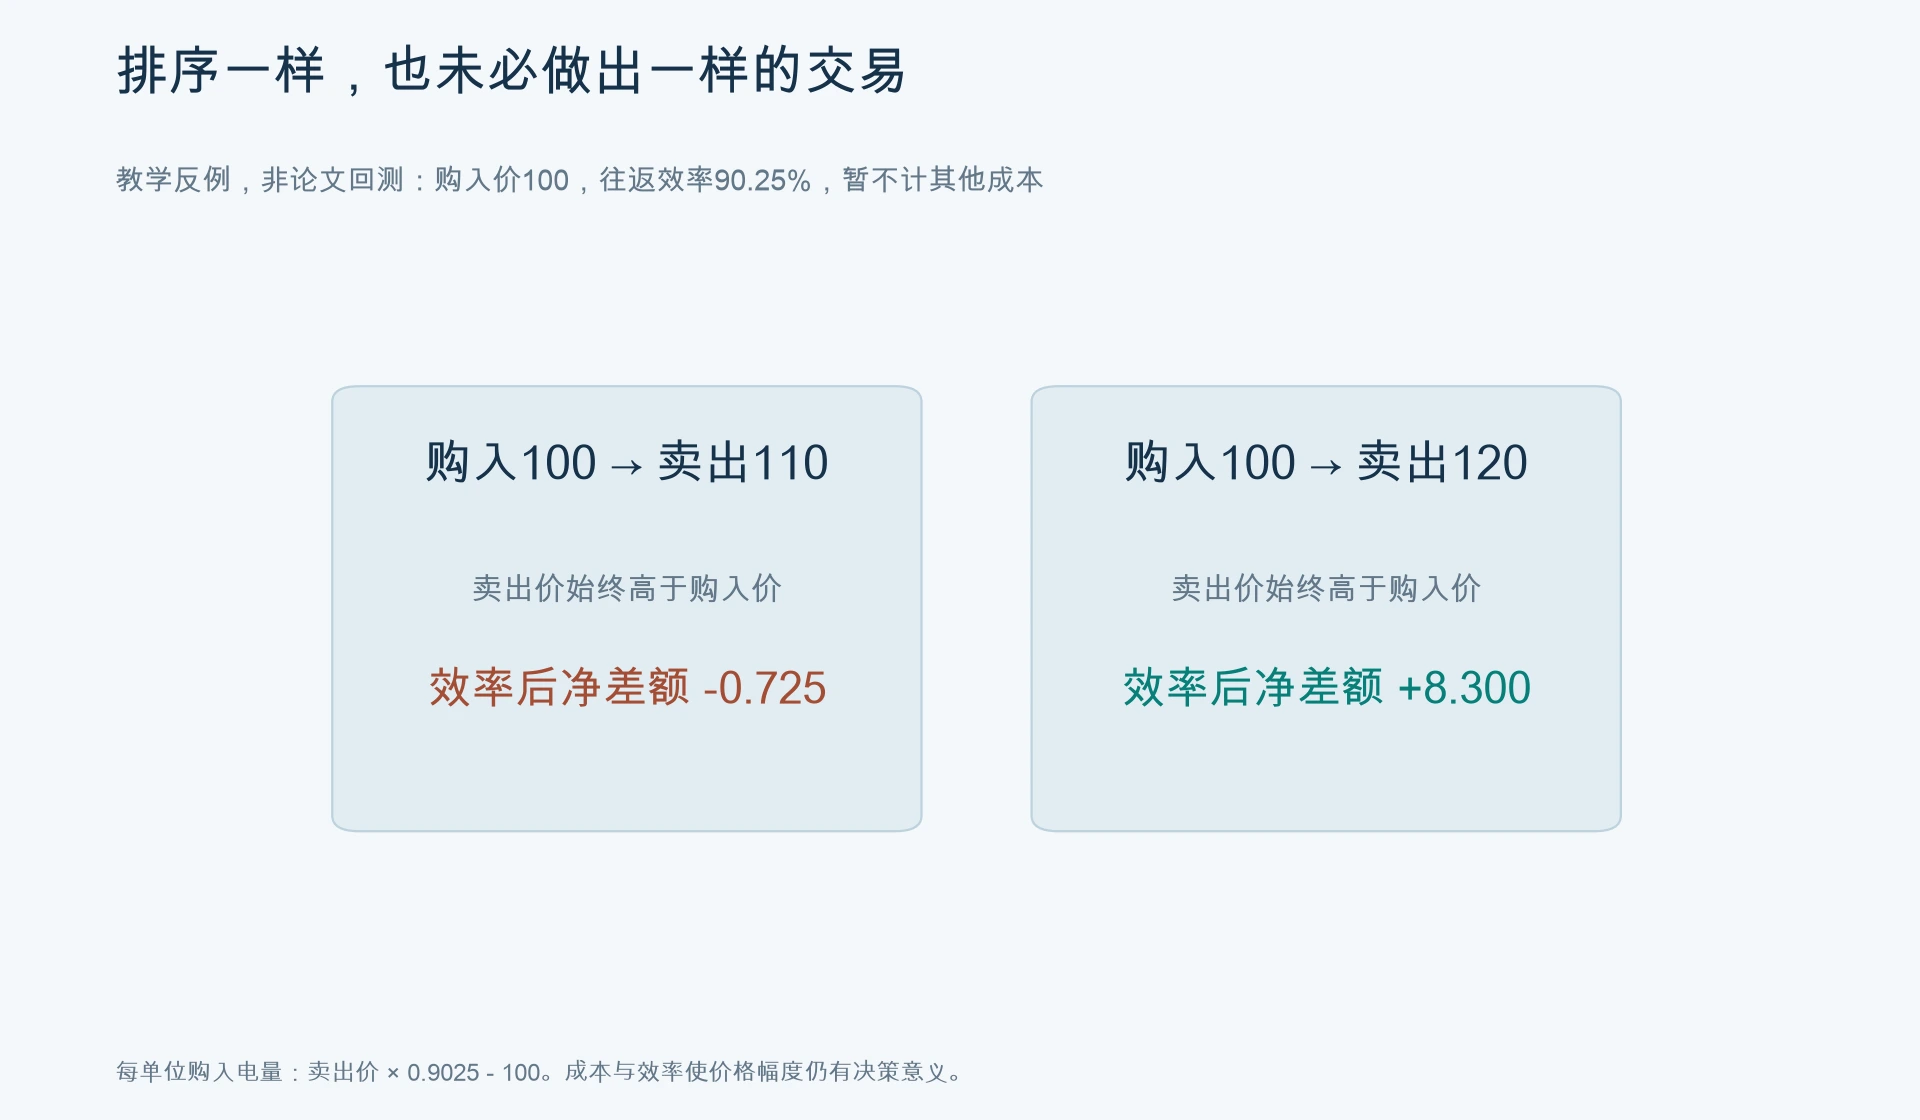
看一个教学反例。假设买电价格都是100,预计卖电价格分别为110和120,两种情形的价格排序完全相同。使用论文给出的90.25%往返效率,且暂不计其他成本,每单位购入电量的净收入差分别为110乘0.9025减100,即-0.725,以及120乘0.9025减100,即8.30。一个连效率损失都覆盖不了,另一个有正价差。排序一致,是否值得交易仍可能不同。
这不是对论文数据的复现,而是检查推论适用范围的简化反例。可以借用的研究思路是:同时检查排序信息与下游收益。不能进一步推成“预测幅度没有用”。
图图4
教学反例:排序一致但净价差符号不同
容量怎么分,也许比预测再精确一点更重要
论文的另一个结果来自备用服务与日内交易之间的资源分配。在其共同参与市场和电量缓冲约束下,作者报告备用容量的单位功率收入约为日内交易的6.5倍。
这个倍数带着很强的条件:为履行备用服务,电池必须留下电量缓冲,日内交易可用的循环空间受到挤压。论文也承认,采用更细的订单簿执行或独立日内运行时,比较口径会变化。因此,6.5倍不能读成备用市场永久优于日内交易。
对因子研究,这提供了一个类比:模型负责寻找机会,组合与执行决定哪些机会真的能做。好比送货路线排得更准,车厢却已被其他订单占满,导航精度提升未必增加送货量。类比的边界是,电池有明确的能量守恒和充放电限制,金融组合还面对冲击成本、相关性变化与对手方行为,不能把两类约束视为同一个模型。
这篇论文也值得做一次“读表审计”
表2适合讨论边际改善,但不同部分的口径仍需区分。正文讨论朴素日前策略时给出30.9%的价值捕获,表3对应行却为46.8%;表3还使用不同配置各自的完美预知基准。本文不把这些比例串成一条可以直接相加的收益贡献链。
样本实现也存在限制。日内交易按15分钟聚合价格、价格接受者方式建模,未完整模拟买卖价差、订单簿和部分成交;自动频率恢复备用的激活用期望值与电量缓冲近似,缺少完整实时耦合。结果接近某个模拟上界,不等于实盘也能接近同一比例。
论文对瑞士水文条件与收入的分析,也明确没有作严格因果识别。统计关联不能因为故事合理,就改写成已经证明的因果关系。以上问题不妨碍讨论研究方法,但会影响我们应当给结论多大权重。
图图5
论文结论的适用范围与限制
给因子和模型评价补上最后一段
做模型比较时,除了记录误差、相关性或分类准确率,还应固定交易规则、成本与资源约束,检查模型替换后究竟改变了哪些信号、持仓和成交。若决策几乎没有变化,应解释变化为何没有传导,而不是只继续压低损失函数。
同时保留统一、可执行的比较基准。样本切分、可用信息、换手与成本口径一旦不同,收益比例看起来接近也可能没有可比性。若存在效率损失或成本门槛,还需把预测幅度和价差一起纳入检查。
这篇论文给出的不是一条新的赚钱公式。它让一个常被跳过的问题变得具体:模型指标的改善,是否改变了你真正能够执行的决策,以及改变之后还剩下多少净价值。
原文:Alessandro Falezza,When Forecast Accuracy Fails: Rank Correlation and Decision Quality in Multi-Market Battery Storage Optimization,arXiv:2604.12082v1,2026-04-13。关键证据见第9页电池参数、第14至16页及表2、第17至18页及表3、第25至26页限制说明。
本文由AI辅助整理并核对原文。配图中表2数字来自论文;简化价格例子标为教学示例。内容仅供研究方法交流,不构成投资建议,模拟与历史结果不代表未来收益。
资料与阅读边界
论文信息与原始链接见本文开头的资料卡。正文中的方法解读和教学示例应与原始资料区分,并按自己的数据与交易约束复核。
历史结果不代表未来表现。使用前请检查数据时间边界、样本独立性、交易成本及适用条件。
关键结论
- 预测误差的改善幅度不一定等于下游决策价值的改善幅度。
- 原表模型排序没有反转,不能把边际收益递减夸大为误差指标完全无效。
- 排序阈值来自特定储能实验,成本与效率约束下仍需检查价格幅度。